Depuis o1 et DeepSeek-R1, certaines IA prennent le temps de poser leur raisonnement avant de répondre. Ce brouillon leur fait gagner en justesse sur les problèmes à étapes (maths, code ou logique), au prix de réponses plus lentes et plus coûteuses. Comment fonctionnent ces modèles de raisonnement et comment en tirer le meilleur ?
Trois âges des modèles de langage
Les grands modèles de langage (les LLM) ont déjà connu trois âges. Les premiers GPT, apparus en 2018, faisaient surtout de la complétion : on leur donnait le début d'un texte et ils en inventaient la suite. Une question toute simple suffisait pourtant à les mettre en échec.
En 2022, ChatGPT marque un tournant : le modèle sait désormais suivre des instructions et il a été ajusté selon les préférences exprimées par des humains, si bien qu'il répond enfin à ce qu'on lui demande et sur le ton attendu.
Le troisième âge est celui des modèles de raisonnement. Le coup d'envoi est souvent attribué à o1, d'OpenAI, que le public a d'abord découvert sous le nom d'o1-preview. Le patron de la maison a d'ailleurs fait savoir, en février 2025, qu'après GPT-4.5 plus aucun de ses modèles ne sortirait sans chaîne de pensée.
Qu'est-ce qui distingue un modèle de raisonnement ?
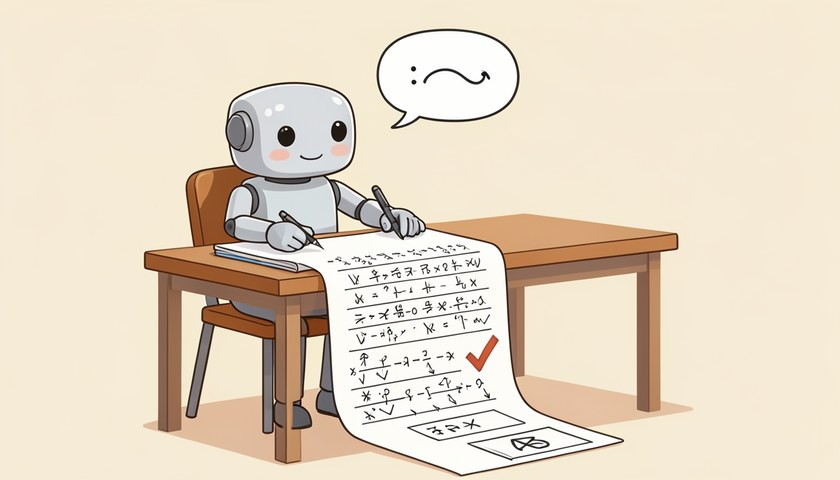
Pour un LLM, raisonner veut dire découper un problème complexe en étapes successives au lieu de sauter directement à la conclusion. Imaginez deux élèves devant le même exercice : le premier annonce un résultat de tête, le second pose ses calculs au brouillon avant de recopier sa réponse. Le modèle classique se comporte plutôt comme le premier et le modèle de raisonnement comme le second.
La différence saute aux yeux à l'usage. Qwen3 existe par exemple en version de base et en version raisonnement : face à la même question, la seconde déroule ses explications d'elle-même, sans qu'on les lui réclame.
Il en découle une conséquence pratique : avec un modèle de raisonnement, inutile d'ajouter "explique étape par étape" à votre demande, puisqu'il le fait déjà et que la consigne ne lui apporte aucun bénéfice.
Renforcement et distillation : d'où vient ce talent
Comment un modèle apprend-il à raisonner ? C'est DeepSeek-R1 qui a levé une bonne partie du voile : diffusé librement, il était accompagné d'un rapport qui détaillait toute la recette, ce qu'aucun modèle de ce genre n'avait fait avant lui. Ses concepteurs montrent que le raisonnement émerge d'un apprentissage par renforcement à récompenses vérifiables (RLVR) : le modèle s'exerce sur des problèmes dont la réponse se contrôle automatiquement (en mathématiques ou en programmation) et il est récompensé quand sa solution est juste.
La variante R1-Zero a d'ailleurs appris à bien raisonner avec ce seul renforcement, et un entraînement en plusieurs étapes a donné un modèle encore meilleur. L'algorithme employé se nomme GRPO et il a été introduit avec DeepSeekMath. Il s'inspire de PPO, l'algorithme d'origine du RLHF, cette méthode qui aligne un modèle sur les préférences humaines. Plusieurs variantes cherchent déjà à l'améliorer, comme DAPO, GSPO ou CISPO.
Seconde piste, la distillation : un grand modèle (le professeur) rédige des raisonnements complets, puis un petit modèle (l'élève) s'entraîne sur ces traces. Dans la version dure, l'élève apprend tout simplement à reproduire les textes du professeur (on parle d'ajustement supervisé). Dans la version douce, il apprend à imiter les probabilités que le professeur donne à chaque mot possible.
Apprendre plus ou réfléchir plus longtemps
Pour améliorer le raisonnement d'une IA, on dispose de deux leviers. Le premier consiste à dépenser plus de calcul pendant l'entraînement. Le second consiste à lui en accorder davantage au moment où elle répond : c'est l'inference-time scaling, appelé aussi test-time scaling. En pratique, les modèles récents combinent les deux.
Ce second levier a une particularité : il ne modifie pas le modèle. Ses poids (c'est-à-dire les réglages internes fixés pendant l'apprentissage) restent les mêmes et seul l'effort fourni pour chaque question augmente. Pensez à un candidat à qui l'on accorde une heure de plus à l'examen : il n'en sait pas davantage, mais il a le temps de vérifier et de raturer.
Cet effort supplémentaire prend trois formes :
- Réfléchir plus longtemps en écrivant une chaîne de pensée plus fournie.
- Produire plusieurs réponses, puis les départager (l'auto-cohérence, autrement dit le vote).
- Se relire et corriger sa réponse en plusieurs passes : c'est l'auto-raffinement.
Dans tous les cas, le modèle écrit davantage et la note de calcul grimpe, avec un gain de précision fréquent mais jamais garanti.
La chaîne de pensée, ou l'art du brouillon
Pas besoin de réentraîner un modèle classique pour le pousser à raisonner : il suffit souvent d'ajouter à la question une petite phrase qui l'invite à poser ses calculs avant de conclure, comme l'élève à qui l'on demande de montrer son brouillon. C'est la chaîne de pensée (chain of thought). La tournure qui a lancé la mode est "Let's think step by step" (pensons étape par étape). Sur la version de base de Qwen3, une autre tournure a donné de meilleurs résultats : "Explain step by step".
Prenons une petite équation : la moitié de (3x - 9) vaut x + 37, combien vaut x ? Livré à lui-même, le modèle de base répond 20, ce qui est faux.
Avec la consigne, le même modèle déroule son calcul. Il multiplie par deux pour se débarrasser de la moitié, retire 2x de chaque côté, isole x et tombe sur 83, la bonne réponse. Rien de magique là-dedans : il a écrit ce qu'un bon élève aurait posé sur sa copie.
 © BravRez IA
Ce que le brouillon apporte, et ce qu'il n'apporte pas
Pourquoi ce brouillon aide-t-il autant ? D'abord parce que chaque étape écrite donne au modèle une chance de plus de repérer une erreur, un peu comme on vérifie une retenue avant de finir une addition. Ensuite parce que les textes de mathématiques et de logique qui ont servi à l'entraîner regorgent de solutions détaillées : en posant ses étapes, le modèle retrouve des schémas qu'il connaît.
Attention, la chaîne de pensée n'apporte aucune connaissance nouvelle. Elle modifie seulement la manière dont le modèle se sert de ce qu'il sait déjà. Le gain se voit surtout là où il faut enchaîner les déductions : un calcul, un programme informatique, une énigme de logique.
Sur une question simple, l'effet peut même s'inverser : des étapes inutiles introduisent des erreurs, c'est la surréflexion (ou overthinking). Et rien ne garantit qu'un raisonnement bien présenté soit juste.
Plusieurs essais, puis un vote
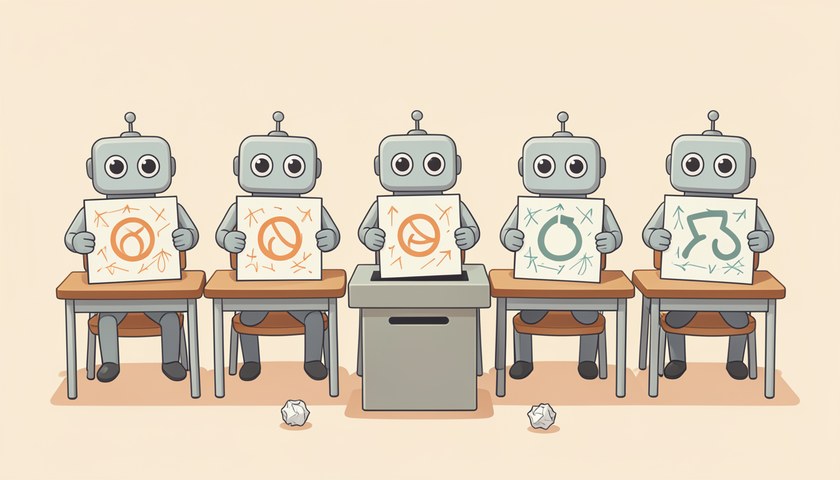
Autre astuce : laisser le modèle répondre plusieurs fois à la même question, puis retenir la conclusion qui sort le plus souvent du lot. C'est le vote à la majorité, ou auto-cohérence (self-consistency), une méthode décrite par Google Research dans l'article "Self-Consistency Improves Chain-of-Thought Reasoning".
Reprenons notre équation avec cinq essais : le modèle donne deux fois 83 et trois autres nombres tous différents, si bien que 83 remporte le vote (et c'est justement la bonne réponse). Avec la chaîne de pensée en plus, les cinq essais s'accordent sur 83.
Comme les essais ne dépendent pas les uns des autres, on peut les lancer en même temps sur plusieurs cartes graphiques : le calcul total est le même, mais le temps d'attente est plus court. Ces essais en parallèle sont déjà utilisés en production, par exemple dans Claude 4. Chez Google, le mode Gemini 3 Deep Think explore lui aussi plusieurs hypothèses en même temps, avec une méthode qui reste secrète : elle est sans doute proche du vote ou du choix du meilleur essai, mais ce n'est qu'une hypothèse.
 © BravRez IA
Les angles morts du vote
Le vote a toutefois ses limites. Dans sa version de base, il ne sait pas quoi faire quand deux réponses arrivent à égalité. Surtout, il a besoin d'une réponse finale courte et facile à extraire, comme un nombre : quand la réponse attendue est un résumé ou un courriel, le vote devient bien plus difficile à appliquer, faute de réponses que l'on puisse comparer simplement.
Une variante appelée Best-of-N donne une note à chaque réponse et garde la réponse qui a la meilleure note. Quand le vote est possible, il donne pourtant souvent de meilleurs résultats que cette méthode. Le vote se combine aussi avec l'auto-raffinement : DeepSeekMath-V2 associe les deux et atteint un niveau de médaille d'or à plusieurs concours de mathématiques.
Rien ne vous empêche d'en faire l'essai chez vous, par simple curiosité : posez la même question de calcul dans trois conversations neuves et regardez si les réponses se rejoignent. Ce n'est pas une preuve, juste une façon de voir le principe à l'œuvre.
Le hasard, un ingrédient à doser
Encore faut-il que les essais soient différents ! En mode normal, dit glouton, le modèle choisit toujours le mot le plus probable : il donne donc la même réponse à chaque essai, et le vote n'a alors aucun sens.
Pour avoir des essais différents, on remplace ce choix par un tirage au sort pondéré : chaque mot a d'autant plus de chances de sortir qu'il est probable. À chaque étape de l'écriture, le modèle calcule un score pour chacune des 151 936 entrées de son vocabulaire (dans le cas de Qwen3) puis convertit ces scores en chances. Après "The capital of Germany is", c'est sans surprise Berlin qui obtient le meilleur score.
Supposons que Berlin ait sept chances sur dix, Munich deux et Hambourg une seule. Sur cent tirages, Berlin sortira environ soixante-dix fois, Munich une vingtaine de fois et Hambourg une dizaine : chaque mot sort en proportion de ses chances. Deux boutons permettent de doser ce hasard : la température et le top-p.
La température, thermostat du hasard
La température est un simple diviseur appliqué aux scores avant le tirage. Réglée à 1, elle ne change rien. Plus basse, elle creuse les écarts : le favori écrase la concurrence et le texte devient plus sûr. Plus haute, elle aplatit la distribution et donne leur chance à des mots improbables.
Le terme vient de la physique, où plus de chaleur veut dire plus d'agitation et donc plus de désordre. L'image colle bien : à une température de 5, Berlin ne conserve que 0,03 % de chances et les mots tirés n'ont plus ni queue ni tête.
Quelques repères pour s'y retrouver : une température nulle revient au mode glouton, des valeurs modérées apportent un peu de variété et une valeur très élevée rend le modèle créatif mais peu fiable.
Top-p : le second bouton, et les réglages pour voter
Le second bouton s'appelle top-p, ou échantillonnage par noyau. On classe les mots du plus probable au moins probable, on garde le plus petit groupe dont les chances additionnées atteignent le seuil p, puis on répartit à nouveau les chances entre les mots qui restent. Avec p = 0,8, une valeur courante, les mots les moins probables sortent du tirage.
Appliqué au vrai modèle sur la phrase de la capitale allemande, ce réglage fait disparaître Munich et Hambourg : Berlin sort alors plus d'une fois sur deux. Il existe une autre méthode, le top-k, qui garde toujours le même nombre de mots, les plus probables. Le top-p est pourtant devenu plus populaire ces derniers temps.
Pour faire voter un modèle, partez d'une température entre 0,5 et 0,9 et d'un top-p entre 0,7 et 0,9. Si toutes les réponses sont identiques, montez les réglages. Si elles deviennent absurdes, baissez d'abord la température. Et ne vous étonnez pas si un processeur classique et une carte graphique donnent des résultats un peu différents : leurs tirages au sort ne sont pas tout à fait identiques.
Comment juge-t-on un modèle qui raisonne ?
Pour noter un modèle, le plus courant est de lui faire isoler sa conclusion dans une case bien repérable (le format "boxed"), que l'on rapproche ensuite du corrigé. Pour les mathématiques, on utilise par exemple MATH-500 : 500 problèmes d'algèbre, de géométrie, de probabilités ou de théorie des nombres, tirés d'un ensemble de 12 500 problèmes (le jeu MATH). Cette sélection de problèmes a été proposée dans l'article "Let's Verify Step by Step".
Qui vérifie les réponses ? Parfois de simples règles symboliques, dites déterministes. Parfois aussi de petits modèles de raisonnement qui jouent le rôle de juges, comme xVerify. D'autres méthodes coexistent : les questionnaires à choix multiples du type MMLU, les duels entre modèles classés par score Elo (Chatbot Arena) ou un LLM chargé de noter les copies des autres. Ces classements publics ont leurs critiques, à commencer par l'étude "The Leaderboard Illusion".
Reste une piste de recherche : juger chaque étape du raisonnement et pas seulement le résultat. Le même article "Let's Verify Step by Step" a ainsi réuni 800 000 annotations qui disent, pour chaque étape de solutions générées par un modèle, si cette étape est juste ou non.
Trois fois plus juste, dix-huit fois plus lent
Un banc d'essai sur la série MATH-500, avec le modèle Qwen3, donne une idée assez nette du prix à payer. Le modèle de base en mode glouton résout 15,2 % des problèmes en une dizaine de minutes pour toute la série. Sa version raisonnement monte à 48,2 %, mais il lui faut un peu plus de trois heures.
Pourquoi un tel écart de temps ? Un modèle écrit un token (un morceau de mot) à la fois et chaque token exige un passage complet dans tout le réseau. Plus la réponse s'allonge, plus le calcul s'alourdit : l'utilisateur attend davantage et celui qui passe par une API paie une facture plus lourde.
Il existe une voie intermédiaire : le simple ajout de la chaîne de pensée au modèle de base fait grimper son score à 40,6 %, en moins de la moitié du temps réclamé par le modèle de raisonnement.
Vote et chaîne de pensée : quel mélange paie le plus ?
Sans chaîne de pensée, le vote seul plafonne autour de 30 % sur le modèle de base, et passer de trois à dix essais n'y change presque rien. Le hasard seul, sans vote, n'apporte pas grand-chose : la chaîne de pensée accompagnée d'un simple tirage au sort fait même moins bien que la chaîne de pensée seule.
La combinaison gagnante associe les deux méthodes. Chaîne de pensée et vote sur dix essais portent le modèle de base à 52 %, soit mieux que le modèle de raisonnement utilisé seul. Le prix : plus de quatorze heures de calcul, près de cinq fois le temps du modèle de raisonnement. Et si ce dernier vote à son tour sur trois essais, il grimpe à 55,2 %.
La leçon est simple : on échange de la précision contre du calcul. Un modèle modeste mais bien guidé peut rivaliser avec un modèle spécialisé, à condition d'accepter d'attendre (et de payer) beaucoup plus.
Avant de s'en servir : limites et bons réflexes
Un modèle de raisonnement n'est pas une IA plus savante : c'est une IA qui travaille plus longtemps sur chaque question. Cette réflexion a un coût bien réel, puisque plus de mots écrits veut dire plus d'attente et plus d'argent. Même l'évaluation devient chère : faire passer sept tests populaires à o1 revenait à environ 1 500 dollars, selon un chiffrage publié par TechCrunch en avril 2025.
D'autres limites sont à garder en tête :
- Sur une question simple, trop réfléchir peut faire dérailler la réponse.
- Un hasard mal dosé peut dégrader le résultat au lieu de l'améliorer.
- Multiplier les essais peut rapporter peu selon la méthode, tout en coûtant toujours plus cher, et le vote suppose une réponse courte.
- Aucune de ces méthodes ne garantit un raisonnement juste.
Une étude d'Apple, "The Illusion of Thinking", invite d'ailleurs à la nuance : ces modèles ressembleraient à des reconnaisseurs de motifs très perfectionnés, ce qui ne les empêche pas d'être très capables.
En pratique, gardez le modèle classique pour les questions courtes et réservez le modèle de raisonnement aux problèmes à étapes : calcul, code, logique. Sans modèle de raisonnement sous la main, demandez "explique étape par étape", reposez la question deux ou trois fois et comparez. Pour tout résultat qui compte, refaites vous-même la dernière étape.