Depuis l'ouverture de ChatGPT au grand public fin 2022, l'éthique de l'IA a quitté les laboratoires pour s'installer dans les comités de direction. Responsabilité, transparence, biais, vie privée, gouvernance : voici de quoi vous faire une idée précise, et surtout de quoi agir.
1- ChatGPT, fin 2022 : quand l'IA générative fait irruption dans le débat public
L'ouverture au grand public de l'agent conversationnel ChatGPT par l'entreprise américaine OpenAI, à la fin 2022, est l'événement qui a fait basculer l'IA générative dans le débat public et, avec elle, les questions éthiques. Ce qui a marqué les esprits n'était pas tant la technologie sous-jacente que la possibilité d'interagir sans filtre et sans manuel d'utilisation avec un logiciel capable de produire des textes de tous types.
Compte rendu de réunion, poème, recette de cuisine, code informatique, et cela dans un grand nombre de langues, en réponse à n'importe quelle requête : c'est cette généralité qui a créé la rupture. Avant, on montrait des démonstrateurs. Après, tout le monde a pu essayer, sur son propre sujet, avec ses propres mots.
La vraie bascule, au fond, c'est la fin de l'"effet démo". Le système peaufiné en laboratoire, vérifié cent fois, qui échouait misérablement le jour J parce qu'une requête imprévue sortait du cadre... ce scénario a cessé d'être la norme. Les agents conversationnels ont démontré qu'ils étaient suffisamment robustes pour réagir à n'importe quelle demande en respectant la syntaxe, les bonnes mœurs et l'apparence de la rigueur.
Et c'est précisément là que naît le problème éthique : un système qui ne plante plus, qui répond toujours et qui répond bien sur la forme, devient beaucoup plus difficile à contrôler qu'un système qui échoue visiblement.
2- Qui a inventé l'intelligence artificielle ? Retour sur ses origines
L'intelligence artificielle n'a pas d'inventeur unique : elle est le produit d'une longue accumulation de travaux de recherche, et il n'existe d'ailleurs pas une seule façon de faire de l'IA. Poser la question "qui a inventé l'IA" revient donc à demander de quelle filiation technique relève le système que l'on a sous les yeux.
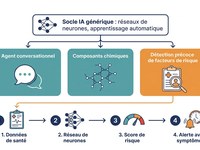
L'IA que l'on connaît actuellement repose sur un socle identifiable : l'apprentissage automatique, les réseaux de neurones, et pour les agents conversationnels les grands modèles de langue. À cela s'ajoute une condition matérielle très concrète, car entraîner ces modèles exige des ressources de calcul considérables, ce qui concentre de fait la capacité de production entre peu de mains.
Cette généalogie a une conséquence éthique directe. Un modèle n'a pas d'intention propre : son comportement découle des données sur lesquelles il a été entraîné, des objectifs qu'on lui a fixés pendant cet entraînement et du matériel qui a rendu l'opération possible.
Autrement dit, chercher qui a inventé l'IA est moins utile que savoir qui a choisi les exemples d'apprentissage. C'est là que se situent les décisions qui engagent une responsabilité.
 © BravRez IA
3- Quelles questions éthiques l'intelligence artificielle soulève-t-elle vraiment ?
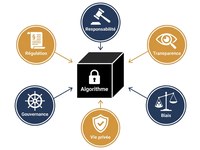
Les questions éthiques soulevées par l'intelligence artificielle se regroupent en quelques familles stables : la possibilité d'induire le système en erreur, le respect de la vie privée, l'amplification des biais, et par-dessus tout cela la responsabilité et la transparence. Les trois premières sont techniques et mesurables, les deux dernières sont organisationnelles et juridiques.
Un élément aggrave l'ensemble : les concepts et les techniques employés pour produire les agents conversationnels sont relativement génériques. Les mêmes briques servent à analyser et générer des images, à prédire le comportement de nouveaux composants chimiques ou à détecter précocement des facteurs de risque en santé.
Conséquence pratique pour qui doit arbitrer : l'enjeu éthique ne dépend pas de la technologie, il dépend de l'usage. Une erreur de génération d'image et une erreur de détection d'un facteur de risque médical relèvent du même socle technique mais pas du même niveau de gravité.
D'où une première règle de travail : ne jamais évaluer "l'IA" en général, mais toujours un couple modèle plus contexte d'utilisation, avec les conséquences concrètes d'une décision fausse dans ce contexte précis.
4- Responsabilité : qui répond des erreurs et des décisions de l'IA ?
Qui est responsable des erreurs de l'IA ? Pas le modèle, qui n'est pas un sujet moral ni un sujet de droit. La responsabilité se répartit le long d'une chaîne humaine : celui qui a constitué le corpus d'entraînement, celui qui a défini les objectifs d'apprentissage, celui qui intègre le modèle dans un produit, et le professionnel qui reprend la sortie à son compte.
Un fait le montre bien. Si un agent conversationnel évite les propos inconvenants ou choquants, ce n'est pas par vertu intrinsèque, c'est uniquement parce qu'il a été longuement entraîné à partir d'exemples pour y parvenir. Le comportement acceptable est un produit d'ingénierie, donc l'imputabilité remonte à ceux qui ont fabriqué et validé cet entraînement.
Pour rendre cela opérationnel dans une organisation, il faut écrire noir sur blanc quatre choses : qui valide la mise en production d'un usage, qui relit les sorties avant qu'elles produisent un effet sur un client ou un salarié, ce qui est journalisé (requête, version du modèle, sortie, décision prise), et à partir de quel niveau d'enjeu une validation humaine devient obligatoire.
Sans ce quatuor, la responsabilité se dissout : chacun renvoie à l'outil, et l'outil ne répond de rien.
5- Transparence des algorithmes : comment ouvrir la boîte noire
Rendre les algorithmes plus transparents ne consiste pas à publier du code : cela consiste à documenter les quatre niveaux qui déterminent réellement le comportement d'un système d'IA. Les données d'entraînement, les objectifs d'apprentissage, le protocole d'évaluation et les limites connues.
Concrètement, une fiche de transparence utile indique la provenance et la période du corpus, les langues et les domaines couverts, ce que le modèle a été entraîné à éviter, la manière dont il a été testé, les cas où il se dégrade, et la version exacte utilisée. Ajoutez l'usage prévu et, surtout, les usages exclus : c'est souvent la mention la plus protectrice.
Nota Bene : on parle de "boîte noire" lorsqu'un système fournit une sortie sans qu'on puisse retracer le cheminement qui y conduit. Avec un grand modèle de langue, l'opacité est structurelle, car le modèle a mémorisé une part immense des connaissances écrites produites par l'humanité et sa réponse résulte de cette masse, pas d'une règle inspectable ligne à ligne.
D'où une distinction à garder en tête : l'explicabilité totale d'une réponse est hors d'atteinte, la traçabilité du processus, elle, est à votre portée. Documenter les entrées, les versions, les validations et les incidents constitue le niveau de transparence réellement exigible.
6- L'IA peut-elle être induite en erreur, se tromper ou halluciner ?
Oui, l'IA peut se tromper, et elle peut être induite en erreur volontairement. Le piège est que la forme reste impeccable : le système respecte la syntaxe, les bonnes mœurs et l'apparence de la rigueur et de la cohérence, or on sait depuis les sophistes que tout cela n'est nullement incompatible avec des raisonnements faux.
Certains ont cru pouvoir inverser la formule bien connue selon laquelle ce que l'on conçoit bien s'énonce clairement : puisque le chatbot s'exprime clairement, il aurait tout compris. En réalité, il est très loin d'avoir tout compris, il a surtout mémorisé une énorme quantité de textes. La clarté n'est pas une preuve de justesse.
Nota Bene : une "hallucination" désigne une sortie bien formée, plausible, cohérente sur le plan du langage, mais fausse sur le fond. Depuis la fin de l'effet démo, le système ne s'effondre plus face à une requête imprévue, il produit une réponse... et une réponse fausse mais assurée est beaucoup plus difficile à repérer qu'un échec visible.
Méthode de protection, simple et efficace : vérifier systématiquement tout élément vérifiable (chiffre, nom, référence, date), tester le système avec des requêtes volontairement piégeuses ou hors périmètre avant la mise en production, et considérer toute sortie comme un brouillon à valider, jamais comme une source.
7- L'IA est-elle respectueuse de la vie privée des utilisateurs ?
L'IA n'est pas spontanément respectueuse de la vie privée : elle l'est seulement si on la conçoit et on l'exploite pour l'être. La raison est mécanique, un grand modèle de langue a mémorisé une grande partie des textes sur lesquels il a été entraîné, donc ce qui entre dans un corpus peut, sous certaines conditions, ressortir dans une réponse.
Il faut distinguer deux moments très différents. Les données d'entraînement, qui façonnent le modèle de façon durable, et les données d'inférence, c'est-à-dire ce que l'utilisateur tape dans sa requête et qui peut, selon le service, être conservé ou réutilisé.
Sur le plan opérationnel, cela se traduit par quelques gestes concrets : minimiser les données envoyées dans une requête, proscrire l'envoi de données personnelles ou de secrets d'affaires dans un service dont on ne connaît pas le régime de conservation, vérifier si les requêtes alimentent un futur entraînement, et documenter cette vérification.
Le point de vigilance particulier concerne les domaines sensibles. Quand les mêmes techniques génériques servent à détecter précocement des facteurs de risque en santé, les données manipulées sont parmi les plus intimes qui existent, et le niveau d'exigence doit suivre.
8- L'IA amplifie-t-elle les biais discriminatoires ?
Oui, l'IA amplifie les biais existants, et elle le fait pour une raison structurelle : elle apprend à partir d'exemples produits par des humains. Un modèle entraîné sur une grande masse de textes reproduit les régularités statistiques de ce corpus, y compris les représentations discriminatoires qu'il contient.
Deux effets se cumulent. L'échelle, d'abord, puisqu'une décision biaisée n'est plus un cas isolé mais un traitement appliqué à des milliers de dossiers. L'apparence de neutralité, ensuite, car un système qui répond avec l'apparence de la rigueur et de la cohérence fait passer une régularité héritée du passé pour un constat objectif.
Pour travailler dessus, il faut mesurer avant de discuter. Cela veut dire évaluer les performances non pas globalement mais par sous-population pertinente pour l'usage, comparer les taux d'erreur entre ces groupes, refaire cette mesure après chaque changement de version du modèle, et consigner les écarts résiduels dans la documentation.
Et une règle d'usage qui vaut pour tous les cas de tri de personnes : la sortie du modèle est un indice, pas un verdict. Elle se présente à un humain qui décide et qui reste comptable de sa décision.
9- Gouvernance de l'IA : qui doit contrôler l'intelligence artificielle ?
Qui doit réguler l'intelligence artificielle ? Aucun acteur ne peut le faire seul. Le contrôle se répartit entre les pouvoirs publics, qui fixent les obligations, la communauté de recherche, qui produit les méthodes d'évaluation, les entreprises qui déploient les systèmes et en connaissent les usages réels, et les utilisateurs, qui doivent être suffisamment informés pour être partie prenante des débats.
Cette dernière condition est décisive et souvent négligée. Sans une compréhension même approximative du socle commun de concepts (apprentissage automatique, réseaux de neurones, grands modèles de langue), le débat se réduit à un affrontement entre promesses et peurs, et la gouvernance devient déclarative.
À l'échelle d'une entreprise, une gouvernance de l'IA qui fonctionne tient en cinq éléments : un inventaire des usages effectifs, une classification de ces usages par niveau de conséquence, une procédure de validation documentée avant mise en production, un canal de signalement des incidents ouvert aux utilisateurs internes, et une revue périodique des usages en service.
Un point de méthode : parce que les techniques employées sont génériques et servent aussi bien pour l'image que pour la chimie ou la santé, la gouvernance doit porter sur les usages et non sur la technologie. Un cadre écrit "pour les chatbots" est obsolète le jour où le même modèle génère des images.
10- Régulation de l'IA : limites, critiques et résistances
La régulation de l'intelligence artificielle se heurte à des limites réelles qu'il serait malhonnête de passer sous silence. La première est un décalage de rythme : les techniques évoluent plus vite que les règles, et surtout elles sont génériques, donc un texte qui viserait un type d'application précis manque aussitôt les autres usages du même socle technique.
La deuxième critique porte sur la transparence elle-même. Exiger qu'un système soit intégralement explicable revient à exiger quelque chose que ses propres concepteurs ne peuvent pas fournir pour un modèle ayant mémorisé une part gigantesque des textes disponibles. Mal calibrée, l'obligation produit de la conformité de papier plutôt que du contrôle effectif.
Troisième résistance, plus sociale : depuis fin 2022, l'essentiel de ce qui a été produit sur l'IA l'a été en réaction à l'événement ChatGPT. D'où une impression largement trompeuse d'avoir déjà tout entendu, une lassitude, parfois une envie d'en finir avec le sujet... qui n'aide pas à construire des règles stables et informées.
Dernière asymétrie, matérielle celle-ci. Entraîner un grand modèle suppose des moyens de calcul importants, ce qui concentre la capacité technique et rend le régulateur dépendant, pour l'expertise comme pour la mesure, de ceux qu'il doit contrôler.
11- Les principes d'une IA de confiance : penser l'éthique dès la conception
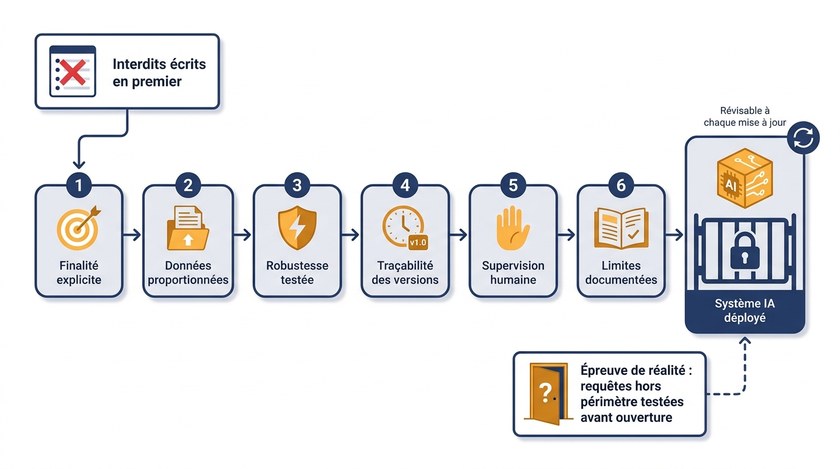
Les principes éthiques d'une IA de confiance ne s'ajoutent pas après coup, ils se décident au moment de la conception. Concrètement : une finalité explicite, des données proportionnées à cette finalité, une robustesse évaluée face aux requêtes imprévues, une traçabilité des versions et des décisions, une supervision humaine aux points d'impact, et une documentation honnête des limites.
Le geste le plus utile est contre-intuitif : écrire ce que le système ne doit pas faire avant d'écrire ce qu'il doit faire. Les garde-fous d'un agent conversationnel ne tiennent qu'à un entraînement long et délibéré sur des exemples de ce qu'il faut éviter, ce qui signifie que tout comportement interdit non spécifié est un comportement autorisé par défaut.
Vient ensuite l'épreuve de réalité. Avant toute ouverture, il faut confronter le système à des requêtes hors périmètre, ambiguës ou malveillantes, noter comment il se comporte, et vérifier qu'il sait répondre "je ne peux pas" plutôt que produire une sortie plausible et fausse.
Enfin, une IA de confiance est une IA révisable. Cela suppose de conserver la version utilisée pour chaque décision significative, de pouvoir revenir en arrière, et de reconduire les mesures de performance et d'équité à chaque mise à jour du modèle, car un changement de version peut modifier le comportement sans prévenir.
 © BravRez IA
12- Vers une IA responsable : ce qu'il reste à construire
Aller vers une intelligence artificielle responsable ne consiste pas à choisir entre enthousiasme et rejet, mais à installer des pratiques vérifiables : savoir d'où viennent les données, qui valide quoi, ce qui est journalisé, et ce que le système n'a pas le droit de faire. C'est moins spectaculaire qu'un débat de principe, et infiniment plus efficace.
Les quatre chantiers sont désormais clairs. La responsabilité, qui doit rester attachée à des humains identifiés le long de la chaîne. La transparence, qui se construit par la traçabilité plus que par l'explicabilité totale. La robustesse, car un système qui ne plante plus produit désormais des erreurs bien formées. Et l'équité, qui se mesure par sous-population ou ne se mesure pas du tout.
Une chose n'a pas changé depuis fin 2022 : un modèle qui s'exprime clairement n'est pas un modèle qui a compris. Garder cette distinction en tête, c'est déjà éviter la majorité des incidents que l'on voit passer en production.
Pour agir dès cette semaine, trois gestes suffisent à amorcer : dresser l'inventaire réel des usages de l'IA dans vos équipes, classer chacun selon la gravité d'une erreur, et écrire pour les plus sensibles qui relit, qui valide et ce qu'on conserve. Le reste, documentation des corpus, tests adverses, mesure des biais, se greffe ensuite sur cette base.
Questions fréquentes
L'ouverture de ChatGPT au public a propulsé l'IA générative dans le débat public, soulevant des questions éthiques sur sa responsabilité et sa transparence.
La responsabilité est partagée entre ceux qui ont conçu le modèle, défini les objectifs d'apprentissage et intégré le modèle dans un produit.
L'IA respecte la vie privée seulement si elle est conçue et exploitée pour cela, en minimisant l'envoi de données personnelles.
L'IA apprend à partir d'exemples humains, reproduisant ainsi les biais présents dans les données d'entraînement, ce qui peut avoir des conséquences à grande échelle.
Il faut documenter les données d'entraînement, les objectifs d'apprentissage, le protocole d'évaluation et les limites connues du système.