Une demande floue produit une réponse moyenne, et ChatGPT n'y peut pas grand-chose. Voici la méthode pour transformer un prompt en vrai cahier des charges, avec des exemples avant et après et des modèles que vous pourrez réutiliser tels quels.
Pourquoi ChatGPT vous répond à côté
Tapez "écris un article sur la cybersécurité des PME" et vous recevrez un texte propre, plutôt court et sans faute... mais interchangeable avec tant d'autres. Le texte ne contient pas d'erreur flagrante, simplement aucune idée qu'un concurrent n'ait déjà publiée : face aux pages déjà en place sur la cybersécurité des PME, Google n'a aucune raison de lui faire une place.
Le modèle n'est pas vraiment en cause : quand on ne lui donne pas de consignes, le modèle comble les vides avec ce qui est le plus probable, donc avec ce qui est le plus moyen, à savoir un ton neutre, un plan attendu et des généralités prudentes.
L'excès inverse est tout aussi courant chez les utilisateurs pressés. Empiler des consignes dans un même message sans jamais vérifier lesquelles sont suivies, c'est ce que les anglophones appellent le "blind prompting" (le prompt à l'aveugle) : on dépense des tokens pour rien et la qualité peut même baisser quand les instructions se contredisent.
Entre les deux, il existe une méthode : elle repose sur cinq principes qui valent dans l'interface de ChatGPT comme dans un appel d'API.
Cinq leviers pour transformer une demande en brief
Un bon prompt se lit moins comme une question que comme un brief adressé à un prestataire. Il se construit autour de cinq leviers qu'il vaut la peine de passer en revue un par un.
- La direction dit quelle tâche accomplir, depuis quel rôle et sur quel ton.
- Le format décrit la forme exacte du livrable, de la liste au JSON en passant par la longueur et le balisage.
- Les exemples montrent le rendu voulu, ce qui parle plus au modèle qu'une longue description.
- L'évaluation consiste à tester la sortie sur plusieurs essais avant de se fier au prompt.
- La division du travail répartit une tâche lourde entre plusieurs prompts successifs.
Passons un prompt ordinaire à cette grille : "Rédige une fiche produit de 300 mots pour notre logiciel de facturation avec un ton professionnel et des phrases courtes, en mettant en avant les avantages clés."
Le ton est fixé mais ni le rôle ni le lecteur ne le sont : la direction reste donc partielle. Rien n'est dit de la mise en forme, hormis une longueur que le modèle respectera approximativement.
Il n'y a ni exemple ni test, et tout repose sur une seule requête. Le plus simple, pour cette fiche, serait de coller sous la consigne la fiche d'un produit voisin que l'équipe a déjà validée. Ce one-shot donne au modèle un étalon de longueur, de ton et de structure, ce qui rend souvent les réponses plus justes et plus constantes.
Le format de sortie, avant et après
Partons d'une demande banale : "Donne-moi des idées de noms pour notre webinaire sur l'IA générative." Sans autre précision, la sortie arrive le plus souvent avec une phrase d'introduction et une liste numérotée de longueur imprévisible, chaque proposition étant suivie d'un commentaire. Tout est à nettoyer avant de pouvoir s'en servir.
La version corrigée verrouille chaque paramètre : "Propose six noms de webinaire sous forme de liste à puces, avec un nom par ligne et quatre mots au maximum, sans explication et sans phrase avant ou après la liste. Voici la forme attendue : 'IA sans jargon' ou 'Le prompt en pratique'."
Ce dernier élément pèse autant que le reste, car un échantillon du résultat guide mieux le modèle qu'une description du résultat.
Pour un plan d'article, deux formulations suffisent à changer la profondeur. Le mot "hiérarchique" pousse le modèle à imbriquer les niveaux (parties, sous-parties et points), tandis que "très détaillé" ou un plancher explicite comme "au moins dix titres principaux" allonge nettement la structure.
Même avec ces consignes, rien ne garantit d'obtenir exactement six noms de webinaire : un modèle de langage compte mal, et un plan annoncé à dix titres principaux peut fort bien s'arrêter deux crans plus tôt. Quand le nombre importe, contrôlez-le dans le code et relancez la requête, ou prévoyez une tolérance.
JSON, YAML, CSV : des réponses lisibles par le code
Dès que la réponse alimente un script, le format devient une question de robustesse. En JSON, la consigne ne doit laisser aucune marge : "Réponds uniquement avec du JSON valide, sans balises de code et sans aucun texte autour." Si l'on ajoute la structure attendue, par exemple {"nom": "", "objet": "", "urgence": "haute ou normale"} pour trier des demandes entrantes, la sortie passera telle quelle dans json.loads.
Sur un tri de demandes entrantes, les incidents typiques se repèrent vite : une phrase de politesse glissée avant l'accolade ("Voici le JSON demandé"), un bloc entouré de backticks, ou un objet que json.loads refuse parce que la sortie a été coupée ou qu'un guillemet n'a pas été échappé. Un try/except autour du parsing suivi d'une relance est une piste raisonnable pour absorber ces incidents.
Le chef de projet qui relit les sorties avant leur entrée dans l'outil préférera sans doute le YAML, où il n'a ni accolades ni virgules à traquer et où il peut annoter une ligne en marge.
Pour d'autres besoins, nommer le format fait déjà une bonne partie du travail. Écrire "en CSV" impose la virgule comme séparateur sans autre explication, et l'on obtient de la même façon un diagramme Mermaid du parcours d'inscription d'un utilisateur ou un jeu de données factice pour tester une base.
Usage moins connu : le modèle peut même tenir lieu de moteur de règles. On lui donne un référentiel en YAML, comme le catalogue d'une agence avec ses prestations et leurs unités de vente, puis le message libre d'un client.
Le modèle renvoie alors les seules lignes conformes au catalogue, et une valeur convenue ("Aucune prestation") quand rien ne correspond, soit un filtrage qu'on aurait d'ordinaire écrit en dur dans le code.
Reste qu'une sortie bien formée n'est pas forcément une sortie juste. Côté code, chaque réponse doit donc passer une série de contrôles qui ont chacun leur propre message d'erreur.
- Toutes les clés attendues sont présentes et leurs types sont ceux que le code attend.
- Chaque élément renvoyé par le modèle existe bien dans le référentiel de départ.
- Les quantités restent sous le plafond fixé et les unités font partie de la liste autorisée.
Prévoir une erreur par cas de figure permet de relancer le modèle avec une correction précise plutôt qu'avec un vague "recommence".
Montrer plutôt qu'expliquer : le few-shot
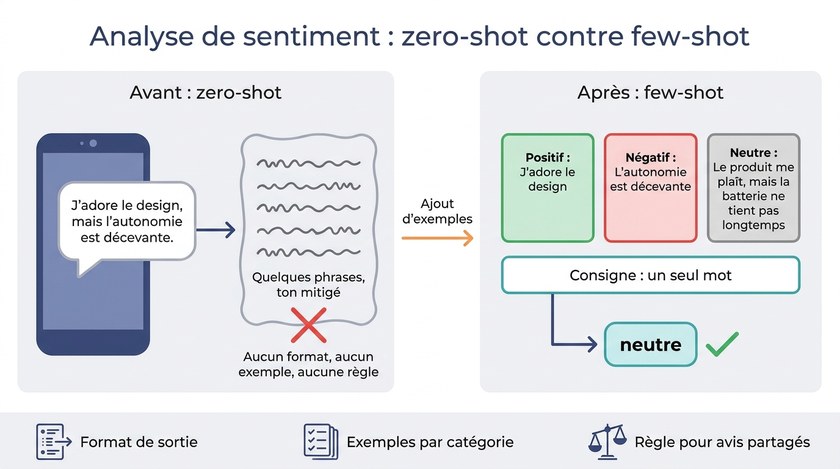
Un prompt sans exemple est dit zero-shot, alors qu'un prompt qui en fournit quelques-uns est dit few-shot. L'écart entre les deux se voit surtout sur la structure et la précision des réponses.
Prenons un avis client soumis tel quel, avec pour seule question "Ce commentaire est-il positif ou négatif ?" : "J'adore le design, mais l'autonomie est décevante." Il faut s'attendre à quelques phrases au ton mitigé, qui pèsent le pour et le contre sans trancher, car le prompt ne fixait ni la forme de la réponse ni le sort des avis partagés et ne montrait aucun cas par catégorie.
La version few-shot commence par la consigne : trois étiquettes possibles (positif, négatif, neutre), un seul mot en sortie, et la règle qui tranche ce genre d'avis, puisqu'un commentaire mêlant compliment et reproche ira dans neutre.
Viennent ensuite trois exemples étiquetés, un par catégorie : "J'adore le design" pour positif, "L'autonomie est décevante" pour négatif et "Le produit me plaît, mais la batterie ne tient pas longtemps" pour neutre. L'avis à traiter arrive en dernier, entre ses délimiteurs, et la réponse tombe en un mot : neutre.
Le troisième exemple compte particulièrement, puisqu'il montre au modèle à quoi ressemble un avis partagé et quelle étiquette lui revient. Format de sortie, exemples par catégorie, règle pour les avis partagés : les trois manques du premier prompt sont comblés un par un.
Les délimiteurs comme ### ou les triples guillemets séparent nettement la consigne du texte à traiter, ce qui empêche le modèle de prendre une phrase de l'avis pour une instruction. Pour un gros volume, il reste prudent de comparer avec un modèle d'apprentissage automatique classique qui, selon le problème, fait parfois mieux.
 © BravRez IA
Donner un rôle, et le surveiller
Donner un rôle au modèle revient à lui demander de répondre depuis un métier ou un point de vue précis, qu'il s'agisse d'un auditeur SEO, d'un juriste, d'un développeur senior chargé d'une revue de code ou d'un client pressé.
Le rôle règle d'un coup le vocabulaire, le niveau d'expertise et le registre de la réponse. Il stimule aussi la créativité et fait surgir des angles qu'on n'aurait pas pensé à demander.
Comparez "Que penses-tu de cette page d'accueil ?" avec cette version : "Tu es consultant en expérience utilisateur et je te transmets le texte de la page d'accueil d'un logiciel B2B. Fais-en une revue complète avec ses points forts, ses faiblesses, les éléments qui manquent et ce qu'un concurrent sérieux proposerait à la place."
La seconde version fixe à la fois le personnage, la matière et le plan de la réponse.
Avec l'API, c'est le message système qui se prête le mieux à la définition du rôle, puisqu'il encadre toute la conversation. Ceux qui manquent d'idées de personnages peuvent puiser dans Awesome ChatGPT prompts, un répertoire public de rôles déjà rédigés.
Le procédé appelle pourtant deux réserves : un rôle porte ses biais et ses stéréotypes, qui se retrouvent dans la réponse, et au fil d'un long échange le modèle finit parfois par sortir de son personnage. Certains praticiens recommandent donc de vérifier à intervalles réguliers qu'il le tient encore.
Laisser le modèle réclamer son contexte
Une question comme "Faut-il passer notre site vitrine sur un CMS headless ?" obtient une réponse équilibrée et prudente, sans recommandation ferme. C'est logique, puisque le modèle ne sait rien de votre trafic, rien de votre équipe et rien de vos contraintes : le modèle n'a donc pas de quoi trancher.
La parade se fait en deux temps. On demande d'abord au modèle quels critères lui seraient nécessaires pour se prononcer, et il en dresse la liste, de la nature des contenus au budget en passant par les compétences de l'équipe. On renseigne ensuite chacun de ces critères, et la réponse devient une recommandation argumentée.
Le réflexe à prendre est de conclure tout prompt important par "Si tu as besoin de plus de contexte, indique-moi ce qui t'aiderait." C'est d'ailleurs le mécanisme de base des agents, qui jugent eux-mêmes si l'information dont ils disposent suffit et qui posent leurs questions dans le cas contraire. AutoGPT pousse le principe plus loin avec une boucle d'auto-vérification où un acteur produit et où un critique contrôle.
Ancrer la réponse pour limiter les hallucinations
Contre les hallucinations, un premier levier consiste à borner le terrain de jeu : "Appuie-toi exclusivement sur le document entre triples guillemets pour répondre." Il faut aussi prévoir une issue quand l'information manque, sous la forme d'une phrase imposée comme "Cette information ne figure pas dans le document." Faute de porte de sortie, le modèle a tendance à combler le vide.
Prenons un extrait de conditions générales qui traite uniquement du délai de rétractation. Une question sur ce délai doit obtenir une réponse sourcée, alors qu'une question sur la garantie, dont l'extrait ne dit rien, doit déclencher la phrase de repli et rien d'autre. C'est exactement ce comportement qu'il faut tester avant une mise en production.
On peut durcir le dispositif en exigeant la citation du passage utilisé, dans un format exploitable du type {"citation": "..."}. Une simple recherche de chaîne dans le document source confirme alors, sans intervention humaine, que la citation existe vraiment.
La limite vient de la fenêtre de contexte : il est impossible de coller toute une base documentaire dans un prompt. Il faut donc d'abord retrouver les passages utiles, puis interroger le modèle sur ces seuls extraits.
Faire réfléchir le modèle avant qu'il tranche
Si l'on montre à un modèle un calcul déjà fait et qu'on lui demande si ce calcul est juste, le modèle risque de le valider sans vraiment le vérifier. Mieux vaut inverser l'ordre des opérations : "Recalcule d'abord la TVA de cette facture de ton côté. Compare ensuite ton résultat à celui de la facture, et seulement après, dis-moi si la facture est exacte."
Faire le calcul seul avant de juger le calcul d'un autre donne souvent des réponses plus fiables, et le modèle a moins de chances de reprendre à son compte une erreur qu'on lui a soufflée.
En formation ou en support, le monologue intérieur rend aussi un vrai service. Le modèle écrit son raisonnement entre triples guillemets, ce raisonnement est masqué à l'affichage, et l'utilisateur ne voit que l'indice final. Un élève qui a oublié un cas dans un exercice de probabilités reçoit ainsi une piste pour avancer, et non la solution de l'exercice.
Le troisième outil est l'auto-critique, qui tient en une phrase : "Relis ta réponse et améliore-la." Sur une petite fonction Python, cette demande peut faire apparaître des annotations de type ou un argument par défaut qui manquaient dans la première réponse. Rien n'empêche de répéter la demande jusqu'à ce que le modèle ne trouve plus rien à améliorer dans sa réponse.
Découper une tâche complexe en chaîne de prompts
Imaginons un petit outil qui contrôle les balises title d'un site, avec son architecture, la fonction qui lit le sitemap et une batterie de tests unitaires. Tout demander dans le même message revient à espérer qu'un seul échange fasse le travail de trois, et chaque morceau risque d'en pâtir.
L'approche dite "du moins au plus" découpe ce chantier en maillons : on obtient d'abord l'architecture (modules, dépendances, flux de données), on la recolle dans le message suivant pour faire coder la lecture du sitemap, puis on transmet ce code pour faire écrire les tests. Chaque maillon se relit et se corrige isolément, en laissant place au dialogue, ce qui permet d'explorer le problème pas à pas.
Le revers de la méthode est double : quand l'historique s'allonge, le modèle peut perdre de vue la demande de départ, et un maillon fragile fragilise toute la suite. Il faut donc relire chaque réponse avant d'enchaîner.
La rédaction d'un article de fond suit la même logique. On rassemble quelques pages de référence que l'on résume par morceaux d'environ 1500 tokens avec 400 tokens de recouvrement, on en tire un plan, puis on rédige section par section en ne fournissant au modèle que les documents utiles à chacune.
Le prompt de section rappelle le titre en cours et fixe la sortie (du Markdown, listes comprises). Il interdit de reprendre les documents mot pour mot, car le plagiat n'est jamais loin, et demande d'intégrer les réponses données par l'auteur lors d'un entretien préalable, qui apportent l'expérience que le modèle n'a pas.
Documents longs : découper avant de résumer
Résumer compte parmi les usages les plus rentables du modèle : un contrat juridique touffu peut ainsi devenir un paragraphe limpide qui dit qui s'engage, sur quoi et comment lire les clauses.
Le même document peut aussi donner plusieurs résumés selon le lecteur visé (points clés, aide à la décision, note pour l'équipe) ou un résumé ciblé du type "liste seulement les risques".
Quand le texte dépasse ce que le modèle peut absorber, on le découpe en morceaux, on résume chaque morceau puis on fusionne les résumés. Le découpage permet de tenir dans la fenêtre de contexte et allège la facture en tokens, tout en accélérant le traitement et en s'ajustant à la tâche. Il est en revanche superflu sur un texte court ou consacré à un seul sujet.
Tout se joue dans le choix de l'endroit où l'on coupe. Découper un contrat mot par mot lui ferait perdre tout son sens, et des tranches fixes de 200 caractères couperaient des clauses au milieu d'un mot. Il vaut mieux couper à la phrase, au paragraphe ou au changement de thème, ou encore selon un budget de tokens.
La fenêtre glissante fait se chevaucher les morceaux successifs : plus le pas est court par rapport à la taille de la fenêtre, plus le recouvrement est important, ce qui se justifie quand la précision prime. Côté budget, n'oubliez pas que la réponse occupe elle aussi de la place dans la fenêtre, si bien qu'un contrat découpé au plus juste ne laisse plus aucune marge pour le résumé. Un compteur comme tiktoken, utilisé avec GPT-4, évite ce genre de mauvaise surprise.
Style de marque et méta-prompts
Pour tenir une voix de marque, commencez par disséquer un texte que vous aimez avec un prompt du type "Analyse cet article et dresse la liste des traits qui permettraient de l'imiter, qu'il s'agisse du ton, de la longueur, du vocabulaire ou de la structure."
Le résultat fait office de guide de rédaction et se réinjecte ensuite dans d'autres prompts ("écris sur tel sujet en reprenant ce ton, cette longueur, ce vocabulaire et cette structure"). Avec le texte de référence joint au prompt, le contenu obtenu est crédible et ne demande que peu de retouches.
Les bénéfices sont concrets : la cohérence de marque, une production plus rapide et la déclinaison d'un même contenu vers d'autres formats. Une seule analyse suffit souvent pour une première version du guide, et rien n'interdit ensuite de mêler les traits de plusieurs plumes. La même mécanique sert à vulgariser, puisque "explique comme si j'avais 5 ans" rend abordable le résumé d'une étude scientifique.
Le méta-prompt va un cran plus loin : c'est un prompt qui écrit d'autres prompts, pour du texte, de l'image ou de la vidéo. Une agence valide le script de sa vidéo de présentation, puis demande au modèle de convertir chaque séquence en consigne visuelle pour Midjourney ou Stable Diffusion.
Le modèle sait aussi retravailler un prompt existant si on le lui demande ainsi : "Tu es ingénieur de prompts. Réécris le prompt ci-dessous pour atteindre cet objectif et renvoie uniquement le nouveau prompt, pas son résultat, suivi d'une liste à puces des points qui comptent."
Dernière précaution, les données sensibles que l'on colle dans un outil (emails, CV, documents clients) peuvent servir à entraîner des modèles, et mieux vaut donc les anonymiser avant de les envoyer.
Évaluer un prompt sans y passer des semaines
Le prompt de fiche produit a donné un bon texte au premier essai : c'est encourageant, sans rien garantir pour le reste du catalogue. La notation manuelle (pouce levé ou baissé) reste la référence, mais elle coûte cher et elle avance lentement.
Commencez par les tests qui se passent de modèle, comme la longueur de la réponse, la validité du JSON ou la présence d'un mot interdit : ces tests sont instantanés et presque gratuits.
La concision, la présence d'un appel à l'action ou le respect du ton relèvent d'un autre outil : un second modèle, plus puissant que le premier (GPT-4 qui note GPT-3.5, par exemple), auquel on demande un simple oui ou non pour chaque critère. Sur un critère aussi simple que la concision, la précision de ce modèle juge peut approcher les cent pour cent.
Pour un critère plus délicat, le respect de la charte éditoriale par exemple, c'est le juge lui-même qu'il faut mettre à l'épreuve : on lui présente des fiches dont on connaît déjà le verdict, et l'on relève combien de fois il se trompe dans un sens ou dans l'autre (faux positifs, faux négatifs).
Pour une équipe marketing qui teste ses prompts de fiches produits, l'écart se voit vite : le juge automatique revient à peu près au dixième de ce que coûteraient des relecteurs, et il rend son verdict pendant la pause café quand une campagne de relecture humaine mobilise des jours, voire des semaines. Ce juge a pourtant ses limites : un coût qui remonte à grande échelle, de la latence et des quotas.
Entre deux formulations du prompt de fiche produit, la comparaison n'a de valeur que sur un échantillon : chaque cas de test passe une dizaine de fois au moins dans chaque version, et l'on compare les moyennes obtenues sur une mesure stable, la similarité cosinus entre embeddings par exemple. En classification, le vote majoritaire (on classe trois fois le même texte et on garde l'étiquette qui revient le plus) fiabilise le verdict au prix d'un délai et d'une facture supplémentaires.
Si aucune variante ne suffit, l'ajustement fin reste possible à partir de 50 exemples au minimum selon OpenAI. Même un produit de l'envergure de GitHub Copilot a reposé en partie sur des évaluations improvisées, ce qui montre qu'un test peu rigoureux vaut mieux que rien.
 © BravRez IA
Les erreurs qui reviennent le plus souvent
Passés au crible, la plupart des prompts décevants tombent dans les mêmes pièges, et savoir les reconnaître fait gagner beaucoup de temps.
- La demande vague et sans contexte risque fort de produire une réponse générique.
- L'absence de format laisse très probablement une sortie qu'il faudra retraiter à la main avant de pouvoir s'en servir.
- Le prompt sans exemple ni test risque de ne révéler ses défauts qu'une fois en production.
- Le prompt fourre-tout demande en une seule requête de chercher, de structurer, de rédiger et de relire, au risque de bâcler chacune de ces étapes.
- Le comptage confié au modèle (nombre de mots, de sections ou d'éléments) devrait plutôt être contrôlé par le code.
- Le rôle jamais vérifié risque de s'effacer au fil d'une longue conversation.
- Les avis clients envoyés tels quels, avec leurs emojis, leurs majuscules rageuses et leurs fautes, risquent de fausser le classement, et un nettoyage préalable ne règle pas tout : l'ironie d'un "Bravo pour le délai de livraison" peut encore échapper au modèle.
- La publication sans retouche livre très probablement un texte qui sonne artificiel, ce que les lecteurs risquent de remarquer.
Un dernier piège tient à la langue : la qualité d'une traduction dépend de la quantité de textes disponibles sur le web dans cette langue, si bien qu'une langue rare donne de mauvais résultats. Le code suit la même règle, puisque des langages très présents sur le web comme Python ou JavaScript sont bien servis, alors que les langages récents le sont beaucoup moins.
Cinq modèles de prompts à adapter
Pour finir, voici quelques gabarits qui combinent les principes vus plus haut et dont il suffit de remplacer les crochets par vos propres éléments.
- Rédaction cadrée : "Tu es [rôle] et tu rédiges [type de contenu] sur [sujet] pour [lecteur cible] avec un ton [ton] et au format [structure et balisage], en t'inspirant de l'exemple placé entre ###. Si tu as besoin de plus de contexte, pose-moi tes questions avant d'écrire."
- Extraction structurée : "Extrais du texte placé entre triples guillemets les champs [liste des champs] et réponds uniquement avec du JSON valide qui respecte cette structure [structure], sans aucun texte autour. Si un champ est absent, mets null."
- Question sur un document : "Ta seule source est le document placé entre triples guillemets : quand il ne permet pas de répondre, ta réponse se limite à 'Information absente du document'. Ajoute ensuite, dans un objet JSON dont l'unique clé s'appelle citation, la phrase exacte du document qui justifie ta réponse."
- Classification : "Classe le texte placé entre ### dans l'une de ces catégories [catégories] et réponds par un seul mot. Pour les cas ambigus, applique la règle suivante [règle] en t'appuyant sur ces exemples [un exemple étiqueté par catégorie]."
- Amélioration d'un prompt : "Tu es ingénieur de prompts. Voici mon prompt [prompt] et l'objectif que je veux atteindre [objectif], alors propose une version améliorée sous la forme d'un seul prompt, sans l'exécuter."
Le fil rouge reste le même d'un usage à l'autre : dire précisément ce qu'on attend, le montrer, le vérifier, et ne jamais demander en une seule fois ce qui se fait mieux en plusieurs étapes. Prenez le prompt que vous utilisez le plus souvent, passez-le à la grille des cinq leviers, puis testez la nouvelle version sur une série de cas réels avant de l'adopter.